파이썬 'cp949' codec can't decode 오류 해결: 한글 깨짐 5가지 경우와 파이썬 3.15에서 달라진 점
UnicodeDecodeError: 'cp949' codec can't decode byte 0xec in position 0: illegal multibyte sequence
이 오류는 UTF-8로 저장된 파일을 cp949(한국어 윈도우 기본 인코딩)로 읽으려 해서 납니다. 대부분은 open()에 encoding='utf-8'을 넣으면 바로 해결됩니다.
with open('memo.txt', encoding='utf-8') as f:
    text = f.read()
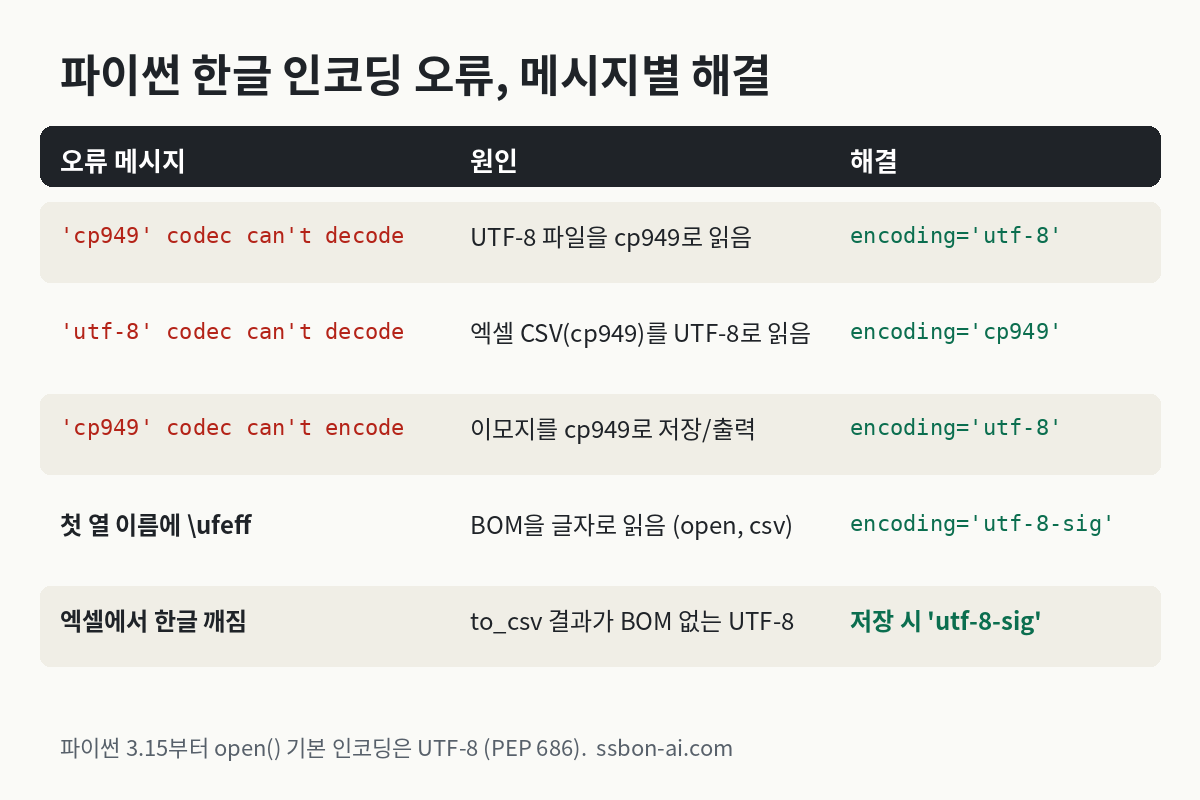
다만 반대 방향(엑셀에서 저장한 CSV를 UTF-8로 읽기)이나 이모지 저장, 엑셀에서 열 때 한글이 깨지는 경우는 해결법이 다릅니다. 아래 다섯 가지 경우를 오류 메시지별로 정리했습니다. 이 글의 오류 메시지와 해결 코드는 모두 2026년 11월 15일에 파이썬 3.13과 pandas 3.0에서 직접 실행해 확인한 결과입니다.
왜 하필 cp949인가
파이썬은 open('파일')처럼 인코딩을 적지 않으면 운영체제 기본값을 씁니다. 리눅스·맥은 UTF-8이지만, 한국어 윈도우는 cp949입니다. 그래서 같은 코드가 맥에서는 되고 회사 윈도우 PC에서는 오류가 납니다. 요즘 파일(VS Code, 메모장 기본 저장, 웹에서 받은 파일)은 대부분 UTF-8인데 파이썬이 cp949로 읽으니 부딪히는 것입니다.
경우 1. 'cp949' codec can't decode … illegal multibyte sequence
- 상황: 한국어 윈도우에서 UTF-8 텍스트 파일을 인코딩 없이
open()으로 읽음 - 오류:
UnicodeDecodeError: 'cp949' codec can't decode byte 0xec in position 0: illegal multibyte sequence(byte 값과 position 숫자는 파일 내용에 따라 다르게 나옵니다. 숫자가 달라도 같은 오류입니다.) - 해결:
encoding='utf-8'을 명시합니다.
with open('memo.txt', encoding='utf-8') as f:
    text = f.read()
오류 없이 읽히는데 한글이 엉뚱한 글자로 깨져 보이기만 할 때도 원인은 같습니다. UTF-8 한글이 cp949로 우연히 "읽혀 버린" 경우입니다.
경우 2. 'utf-8' codec can't decode … invalid start byte
- 상황: 엑셀에서 "CSV(쉼표로 분리)"로 저장한 파일을 UTF-8로 읽음. 한국어 윈도우 엑셀의 이 형식은 cp949로 저장됩니다.
- 오류:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc0 in position 0: invalid start byte - 해결: 이번에는 반대로
encoding='cp949'로 읽습니다. pandas도 같습니다.
import pandas as pd
df = pd.read_csv('엑셀저장.csv', encoding='cp949')
pandas의 read_csv는 기본값이 UTF-8이라, 엑셀에서 만든 CSV를 그냥 읽으면 이 오류가 납니다. 엑셀에서 저장할 때 형식을 "CSV UTF-8(쉼표로 분리)"로 고르면 처음부터 UTF-8 파일이 만들어집니다(이때는 경우 4를 참고하세요).
경우 3. 'cp949' codec can't encode character '\U0001f600'
- 상황: 이모지나 cp949에 없는 문자를 cp949로 저장함. 한국어 윈도우에서
python 스크립트.py > 결과.txt처럼 출력을 파일로 넘기거나, subprocess·작업 스케줄러처럼 다른 프로그램이 파이썬 출력을 받아 갈 때print()에서도 납니다(콘솔 창에 바로 찍을 때는 보통 나지 않습니다). - 오류:
UnicodeEncodeError: 'cp949' codec can't encode character '\U0001f600' in position 4: illegal multibyte sequence - 해결: 파일은
encoding='utf-8'로 저장합니다.print()에서 나는 경우에는 출력 인코딩을 바꿉니다.
with open('out.txt', 'w', encoding='utf-8') as f:
    f.write('좋아요 😀')

import sys
sys.stdout.reconfigure(encoding='utf-8')  # print에서 오류가 날 때
코드를 고치기 어렵다면 실행할 때 python -X utf8 스크립트.py로 돌리거나, 환경 변수 PYTHONIOENCODING=utf-8을 주는 방법도 있습니다.
참고: '똠', '뷁'은 cp949로도 저장됩니다
'똠', '뷁' 같은 글자는 cp949로도 저장됩니다. cp949는 옛 완성형(EUC-KR)을 넓혀 한글 11,172자를 모두 담은 인코딩이기 때문입니다. 문제는 이모지와 일부 특수 문자입니다.
내 코드가 아닐 때 (pip install, 남이 만든 라이브러리)
pip install 도중이나 설치한 라이브러리 안에서 cp949 오류가 나면 코드를 고칠 수가 없습니다. 이때는 UTF-8 모드를 켠 채로 다시 실행합니다.
명령 프롬프트(cmd)에서는:
set PYTHONUTF8=1
pip install 패키지이름
PowerShell에서는:
$env:PYTHONUTF8 = "1"
pip install 패키지이름
이 설정은 그 창을 닫으면 사라집니다. 매번 켜고 싶다면 윈도우의 시스템 환경 변수에 PYTHONUTF8을 1로 추가합니다. 다만 이렇게 전체로 켜 두면, 인코딩 없이 cp949 파일을 읽던 기존 스크립트가 경우 2 오류를 낼 수 있습니다.
경우 4. 첫 열 이름 앞에 \ufeff가 붙음
- 상황: 오류는 안 나는데
open()이나csv모듈로 읽은 첫 열 이름이'\ufeff이름'처럼 나와서'이름'으로 찾으면 못 찾음 - 원인: 파일 맨 앞의 BOM(UTF-8 표시 3바이트)을 글자로 읽은 것. 엑셀의 "CSV UTF-8" 형식이나 윈도우 메모장에서 저장한 일부 파일에 붙어 있습니다.
- 해결:
encoding='utf-8-sig'로 읽으면 BOM을 알아서 떼어 냅니다. BOM이 없는 일반 UTF-8 파일도 그대로 읽히니, 출처가 엑셀·윈도우인 UTF-8 파일은utf-8-sig로 읽는 습관이 편합니다.
import csv
with open('엑셀UTF8.csv', encoding='utf-8-sig', newline='') as f:
    rows = list(csv.reader(f))
pandas의 read_csv는 encoding='utf-8'이어도 BOM을 알아서 떼어 주므로 이 문제가 없습니다(직접 확인).
경우 5. 내가 만든 CSV를 엑셀로 열면 한글이 깨짐
- 상황: 파이썬에서
to_csv()로 저장한 파일을 엑셀에서 더블클릭하면 한글이 깨짐 - 원인: BOM 없는 UTF-8을 엑셀이 cp949로 짐작해서 엶
- 해결: 저장할 때
utf-8-sig를 씁니다. 파일 앞에 BOM이 붙어 엑셀이 UTF-8로 알아봅니다.
df.to_csv('결과.csv', index=False, encoding='utf-8-sig')인코딩을 모를 때 쓰는 함수
어떤 파일이 UTF-8인지 cp949인지 모를 때는 둘 다 시도하는 작은 함수가 실용적입니다. UTF-8로 먼저 시도하는 이유는, cp949 파일이 우연히 UTF-8로 읽힐 가능성이 매우 낮기 때문입니다. 반대로 cp949를 먼저 시도하면 안 됩니다. 무작위 한글 두 글자를 UTF-8로 저장해 cp949로 읽어 보니 2,000번 중 약 38%가 오류 없이 엉뚱한 글자로 읽혔습니다. 오류가 안 나니 함수는 잘못된 결과를 그대로 돌려줍니다.
def read_text(path):
    for enc in ('utf-8-sig', 'cp949'):
        try:
            with open(path, encoding=enc) as f:
                return f.read()
        except UnicodeDecodeError:
            continue
    raise ValueError(f'{path}: utf-8, cp949 둘 다 아님')
errors='ignore'나 'replace'는 해결이 아니다
검색하면 errors='ignore'를 붙이라는 답이 많습니다. 오류 메시지는 사라지지만, 실제로는 글자를 버리거나 바꿔 넣는 것입니다. 직접 해 보면 UTF-8 파일을 encoding='cp949', errors='replace'로 읽었을 때 "안녕하세요"가 �븞�뀞�븯�꽭�슂처럼 깨진 채로 읽힙니다. 데이터가 망가진 줄도 모르고 다음 단계로 넘어가게 되니, 인코딩을 맞추는 쪽으로 고치는 것이 맞습니다.
파이썬 3.15부터 달라진 점
2026년 10월 9일에 나온 파이썬 3.15부터는 UTF-8 모드가 기본으로 켜집니다(PEP 686). UTF-8 모드는 파일과 입출력의 기본 인코딩을 운영체제와 상관없이 UTF-8로 쓰는 설정입니다. 이제 한국어 윈도우에서도 open('파일')을 인코딩 없이 쓰면 cp949가 아니라 UTF-8로 읽고 씁니다.
- 좋아지는 점: 경우 1(UTF-8 파일을 cp949로 읽는 오류)은 3.15에서 거의 사라집니다. 출력을 파일로 넘길 때
print()에서 나던 경우 3 오류도 출력이 UTF-8로 바뀌어 사라집니다. 다만 그 결과 파일을 cp949로 읽던 다른 프로그램에서는 한글이 깨질 수 있습니다. - 새로 조심할 점: 반대로 예전에 인코딩 없이 cp949 파일을 잘 읽던 코드는, 3.15로 올리면 경우 2의
'utf-8' codec can't decode오류를 내기 시작합니다. 엑셀 CSV를 다루는 오래된 업무용 스크립트가 대표적입니다. - 예전처럼 돌리기: 당장 고칠 시간이 없으면 환경 변수
PYTHONUTF8=0또는python -X utf8=0 스크립트.py로 실행하면 이전 동작으로 돌아갑니다. - 3.14 이하에서 미리 맞추기: 반대로 3.14 이하에서도
python -X utf8 스크립트.py또는PYTHONUTF8=1로 실행하면 3.15와 같은 동작을 미리 쓸 수 있습니다. - 인코딩 빠진 곳 찾기:
python -X warn_default_encoding 스크립트.py로 실행하면encoding을 적지 않은open()자리마다EncodingWarning: 'encoding' argument not specified경고가 나옵니다.
버전과 상관없이 가장 확실한 방법은 모든 open()과 read_csv()에 encoding을 직접 적는 것입니다. 그러면 어느 PC, 어느 파이썬 버전에서도 같은 결과가 나옵니다.
한 줄 요약표
| 오류 메시지 | 원인 | 해결 |
|---|---|---|
| 'cp949' codec can't decode | UTF-8 파일을 cp949로 읽음 | encoding='utf-8' |
| 'utf-8' codec can't decode … invalid start byte | 엑셀 CSV(cp949)를 UTF-8로 읽음 | encoding='cp949' |
| 'cp949' codec can't encode character | 이모지를 cp949로 저장·출력 | encoding='utf-8', sys.stdout.reconfigure |
첫 열 이름에 \ufeff (open·csv 모듈) |
BOM을 글자로 읽음 | encoding='utf-8-sig' |
| 엑셀에서 한글 깨짐 | BOM 없는 UTF-8 | to_csv(..., encoding='utf-8-sig') |
2026년 11월 15일 파이썬 3.13.18, pandas 3.0.5에서 직접 실행해 확인했습니다. 파이썬 3.15 내용은 공식 릴리스 페이지와 PEP 686을 기준으로 정리했습니다.
초안 작성과 검수에 AI를 사용했고, 글의 코드와 오류 메시지는 모두 직접 실행해 대조했습니다.
출처
- PEP 686 – Make UTF-8 mode default: https://peps.python.org/pep-0686/
- Python 3.15.0 릴리스 페이지: https://www.python.org/downloads/release/python-3150/
- Python 문서 – UTF-8 모드: https://docs.python.org/3/library/os.html#utf8-mode
- pandas read_csv 문서: https://pandas.pydata.org/docs/reference/api/pandas.read_csv.html